Pando: cuando los agentes de IA obligan a escalar la infraestructura de Git
Un agente de programación no solo produce código. También crea ramas, envía commits, activa CI y descarga historial. Cuando un equipo trabaja con varios agentes en paralelo, una parte silenciosa de la infraestructura de desarrollo recibe de repente muchas más peticiones.
El 2 de noviembre, OpenAI describió Pando, un nuevo backend de Git para su monorepositorio. La empresa afirma que Pando ya sirve todo el desarrollo de ese repositorio y mantiene la compatibilidad con el protocolo y el cliente de Git. Según OpenAI, en su entorno de producción la latencia mediana de push se redujo casi cinco veces y el servicio entrega casi un petabyte de datos Git al día. Son resultados comunicados por OpenAI para su propia carga de trabajo, no una referencia universal.
Lo que me interesa es el límite que eligieron cambiar. OpenAI no pidió a personas y agentes que abandonaran Git; cambió cómo se sirve el repositorio.
Dos tipos de presión
Git almacena el historial como objetos: los blobs contienen archivos, los árboles describen directorios y los commits apuntan a instantáneas y padres. Las ramas son referencias, o refs, que apuntan a commits.
Un backend ocupado debe atender escrituras de nuevos cambios y lecturas del historial. Si cada actualización independiente de una rama espera una única operación que ordena todo el repositorio, los agentes pueden formar cola detrás de trabajo que no tiene relación con su rama. A la vez, generar un packfile específico para cada lector consume CPU y ancho de banda de almacenamiento.
Pando afronta estas presiones con dos decisiones relacionadas:
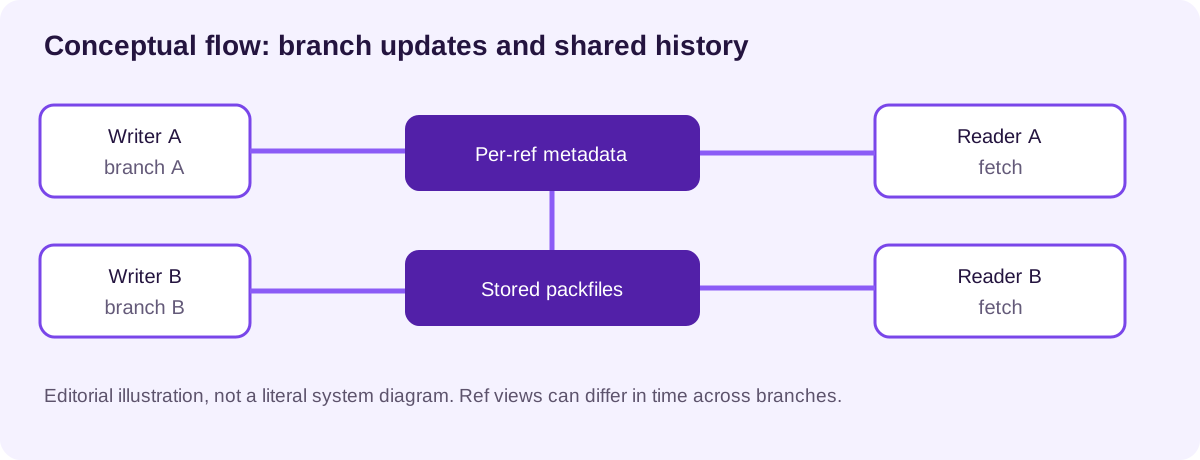
- Coordinar cada ref por separado. Los pushes a ramas distintas pueden avanzar en paralelo. Las actualizaciones que compiten por la misma ref siguen necesitando coordinación.
- Reutilizar packfiles almacenados entre lectores. Un cliente puede recibir objetos que ya tiene, pero el backend puede servir los mismos bytes a muchos lectores sin calcular una respuesta única para cada uno.
Son decisiones arquitectónicas, no una afirmación de que todos los servidores Git deban funcionar así. Su utilidad depende de la carga y de las garantías de consistencia que el equipo necesite.
La concurrencia tiene una contrapartida de consistencia
El detalle importante es lo que Pando no promete: quien lee varias refs no puede asumir que todas representan un único momento del repositorio. OpenAI lo describe como consistencia causal entre referencias, con actualizaciones serializables en cada ref individual. El historial necesario para obtener una ref debe estar disponible, pero dos ramas actualizadas de forma independiente pueden observarse en momentos distintos.
Esta diferencia importa si una herramienta compara varias ramas como si hubiera tomado una instantánea atómica. Yo empezaría por identificar qué presupone esa herramienta y probaría esas hipótesis antes de cambiar el modelo de almacenamiento. Un push más rápido ayuda; un modelo de consistencia mal entendido puede complicar la depuración.
Qué puede aprender un equipo de ingeniería
La mayoría de los equipos no necesita construir Pando. Sí puede aprovechar las preguntas que motivaron su diseño:
- Medir ambos lados. Separar latencia y errores de push y fetch antes de decidir dónde está el cuello de botella.
- Seguir la propagación. Un push puede llevar a varios trabajos de CI y agentes a descargar el mismo historial. Contar lectores y escritores.
- Documentar las hipótesis de consistencia. Identificar la automatización que depende de una única vista de varias ramas y probarla.
- Cuidar protocolos e interfaces. OpenAI eligió la compatibilidad con Git, permitiendo que los clientes existentes siguieran funcionando mientras cambiaba el backend.
- Usar las cifras de la empresa como contexto. Medir el propio repositorio y la propia infraestructura antes de predecir mejoras.
OpenAI también describe una distribución pública de Git y dice que planea contribuir mejoras del cliente al proyecto original. Su repositorio público de Git es distinto del backend Pando descrito en el artículo; el informe no establece que Pando se haya publicado como código abierto.
Más agentes pueden multiplicar los cambios en curso. El reto es que compartirlos sea eficiente sin perder de vista lo que cada lector tiene garantizado ver.
Fuentes
- OpenAI: Scaling Git at OpenAI, 2 de noviembre de 2026.
- Distribución de Git de OpenAI.
- La miniatura utiliza el logotipo original de Git de Jason Long, bajo licencia CC BY 3.0, de la página oficial de logotipos del proyecto Git. Identifica el software y protocolo Git; no implica respaldo del proyecto.
Fuentes revisadas el 9 de noviembre de 2026. Sigue jpalanco.com para más notas sobre IA, ingeniería y herramientas de código abierto.